Candy AI 图像生成提示词撰写完整指南
官方推荐写法
根据 Candy AI 官方帮助中心的建议,好的图像提示词应该描述完整场景,而不只是描述主体。
推荐写法
"我需要一张角色坐在沙发上看 Netflix 的图片"
不太推荐
"沙发 + 看电视 + 角色"
前者描述了完整的情境(谁、在哪、在做什么、氛围是什么),AI 更容易理解你想要什么。后者只是几个关键词堆叠,AI 需要自己补全上下文,容易偏离预期。
提示词的结构公式
一个好用的图像提示词可以按这个顺序组织:
[主体是谁] + [在什么位置/场景] + [在做什么动作] + [周围有什么] + [光线/氛围]示例
| 结构部分 | 内容 |
|---|---|
| 主体 | 角色(Candy AI 图像生成器已锁定,不需要重复写) |
| 位置/场景 | 清晨的阳台,外面有绿植 |
| 动作 | 靠在栏杆上喝咖啡,看向远方 |
| 周围 | 旁边的木桌上放着一本翻开的书 |
| 光线/氛围 | 柔和的金色晨光,电影感 |
组合起来:
靠在清晨阳台的栏杆上喝咖啡,看向远方。旁边木桌上放着一本翻开的书,金色晨光洒进来,电影感光线。
正反例对比
反例(效果差)
"漂亮,女孩,蓝色,好"
问题:太泛,没有场景,AI 不知道画什么。
正例(效果好)
坐在书店的窗边读一本旧书,午后阳光从窗外斜射进来,书页上有光影斑驳,表情专注。
好在哪里:有场景(书店窗边)、有动作(读旧书)、有光线(午后阳光、光影斑驳)、有细节(表情专注)。
常见陷阱
陷阱一:互相矛盾的描述
同时出现"站着"和"躺着"、"全身照"和"脸部特写"这类矛盾指令,AI 会不知道该执行哪个。每次生成只聚焦一个场景和一个动作。
陷阱二:负面词堆太多
很多图像生成工具允许写"负面提示词"(不要什么),但 Candy AI 的图像引擎不依赖负面提示词。写太多"不要 X 不要 Y"反而可能干扰模型理解。专注描述你想要的就好。
陷阱三:过度依赖预设词
预设风格很好用,但不要全部靠预设。在预设基础上写一两句场景描述,效果会比纯预设好得多。
陷阱四:反复重生
每次生成都消耗代币。与其反复点"重新生成"赌运气,不如回来微调提示词里的关键描述。提示词里的一个小修改(比如把"明亮光线"改成"柔和侧光")可能比重生十次都有用。
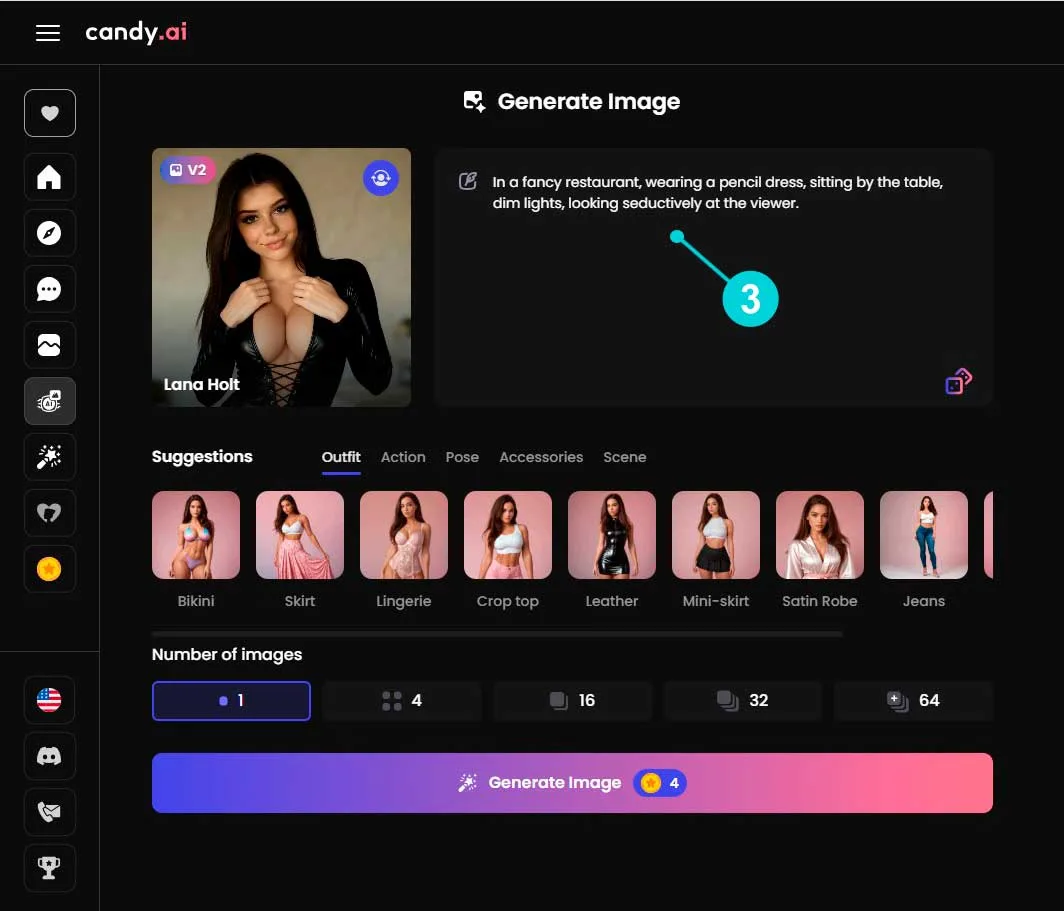
快速上手的建议
- 第一次用:只选预设风格,不写提示词,快速出一张看看整体效果
- 第二次:在预设基础上加一两句场景描述
- 第三次:试着自己写完整提示词,对比预设+提示词的效果差异
- 找到你最常用的场景模板,保存几个"种子提示词"以后复用
下一页:V1 与 V2 图像引擎